ИИ-правка снимков создаёт ложные воспоминания — эксперимент MIT Media Lab
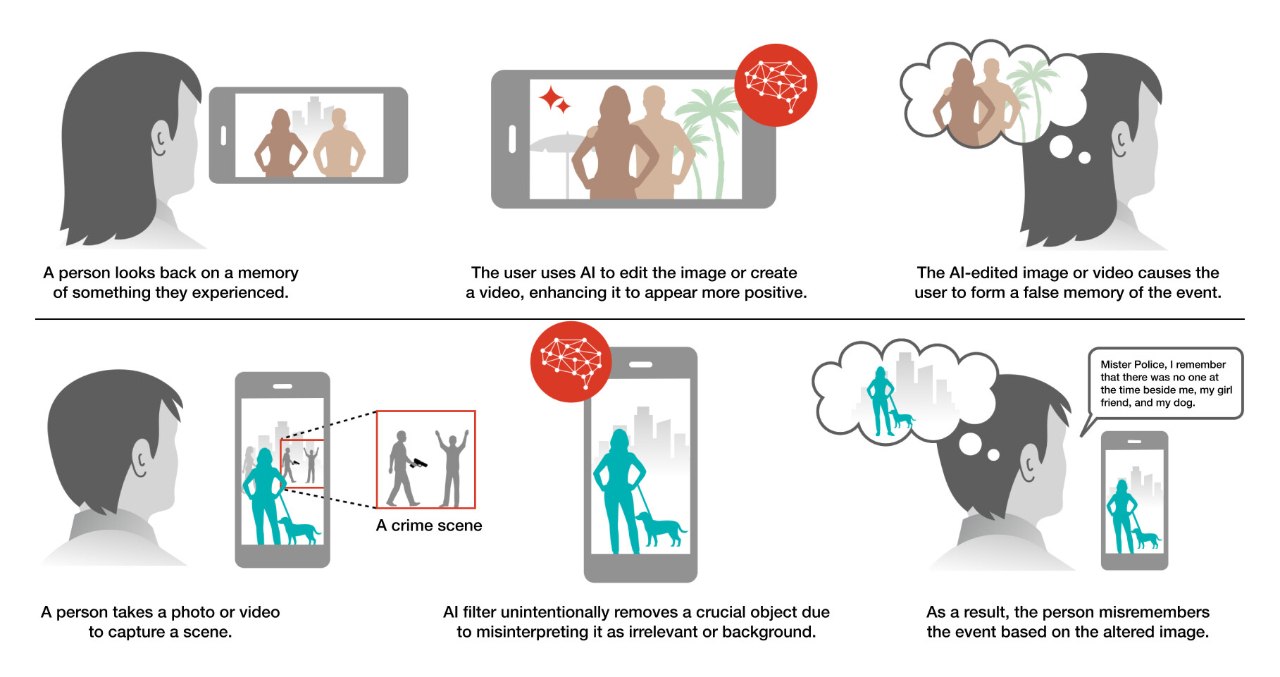
Кажется, что уж собственные фотографии мы помним хорошо. Но в MIT Media Lab проверили, что происходит с памятью, когда мы смотрим на «улучшенные» ИИ копии снимков, — и оказалось, что люди начинают уверенно вспоминать то, чего на исходном кадре не было. Эксперимент провела группа профессора Пэтти Маес вместе с Элизабет Лофтус — пожалуй, самым известным в мире исследователем ложных воспоминаний.
Работу представили ещё на конференции CHI 2025, но сейчас, когда ИИ-редакторы встроены почти в каждую галерею смартфона, о ней снова заговорили.
Как проходил эксперимент
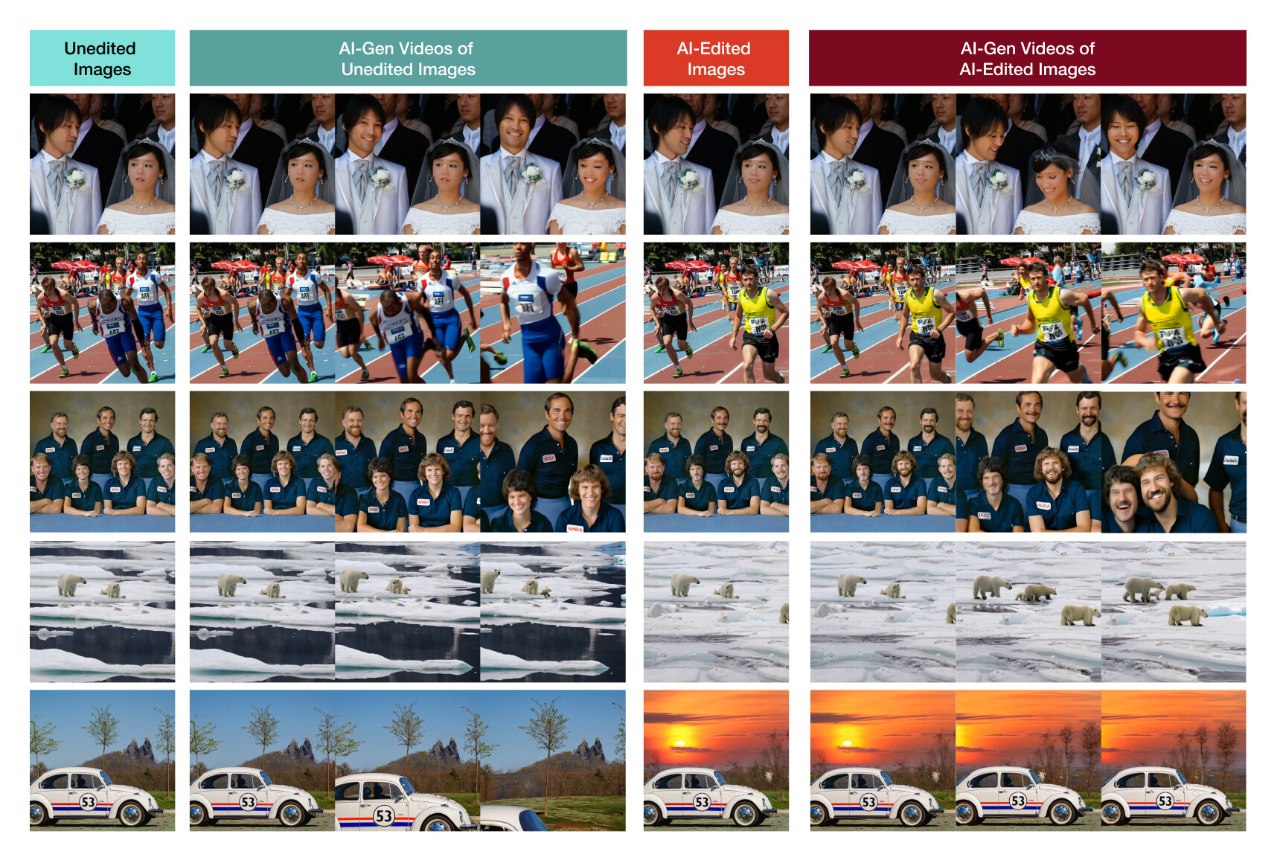
⚬ 200 участников две минуты листали 24 самых обычных снимка, как в ленте соцсети: свадьба, улица, забег, белые медведи на льдине. Потом ещё две минуты отвлекались на Pac-Man.
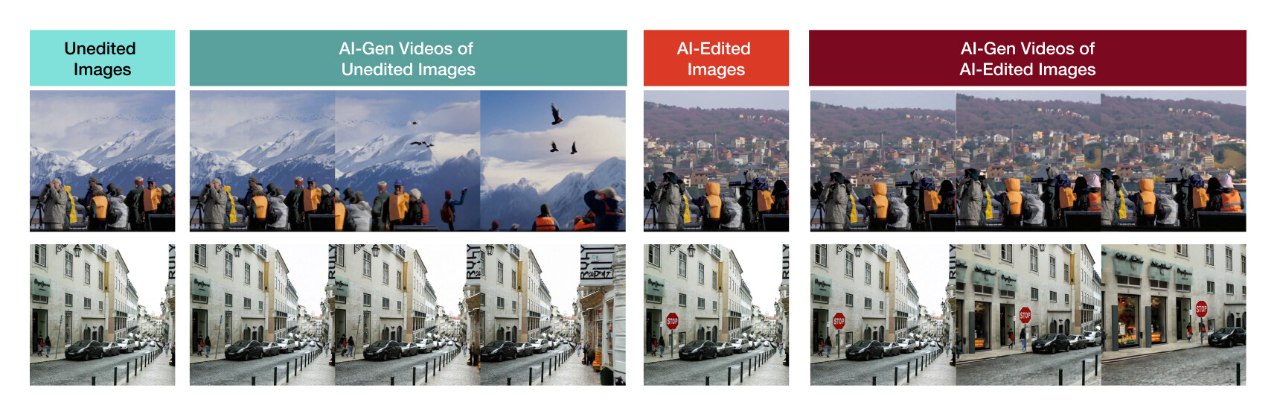
⚬ Затем их разделили на четыре группы по 50 человек. Одна снова смотрела оригиналы, вторая — версии, отредактированные генеративными инструментами Photoshop, третья — пятисекундные ролики, «оживлённые» из оригиналов в Luma Dream Machine, четвёртая — такие же ролики из отредактированных снимков.
⚬ Правки точечные, но меняют смысл: невеста вдруг улыбается, ясный день превращается в закат, на улице появляется знак «Стоп», а горы за спинами туристов — в город.
⚬ Все кадры второй серии были подписаны как «улучшенные ИИ» — участники знали, что смотрят обработку.
⚬ В конце — 24 вопроса, по одному на снимок: например, «Улыбалась ли невеста на исходном фото?».
Ложных воспоминаний оказалось больше во всех трёх «ИИ-группах». Сильнее всего память переписывали ролики из уже изменённых снимков: ложных воспоминаний — в 2,05 раза больше, чем в контрольной группе, а уверенность в неверных ответах — в 1,19 раза выше. Чаще всего путались в людях: в выражениях лиц и внешности.
«Я считаю всё это, по сути, очень опасным», — говорит Пэтти Маес.
Brain-IT: картинка прямо из мозга
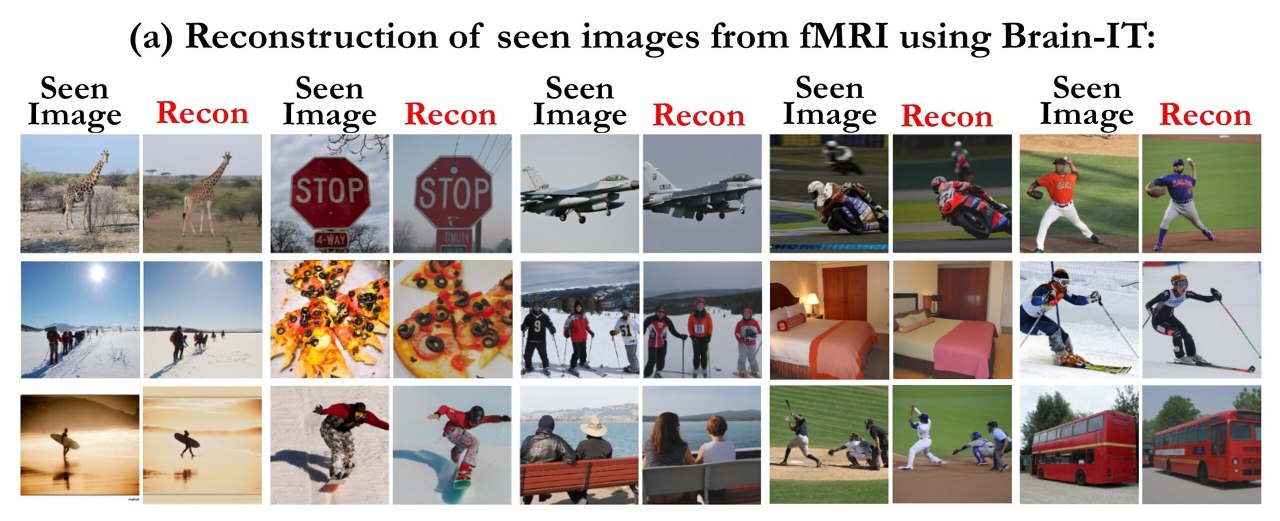
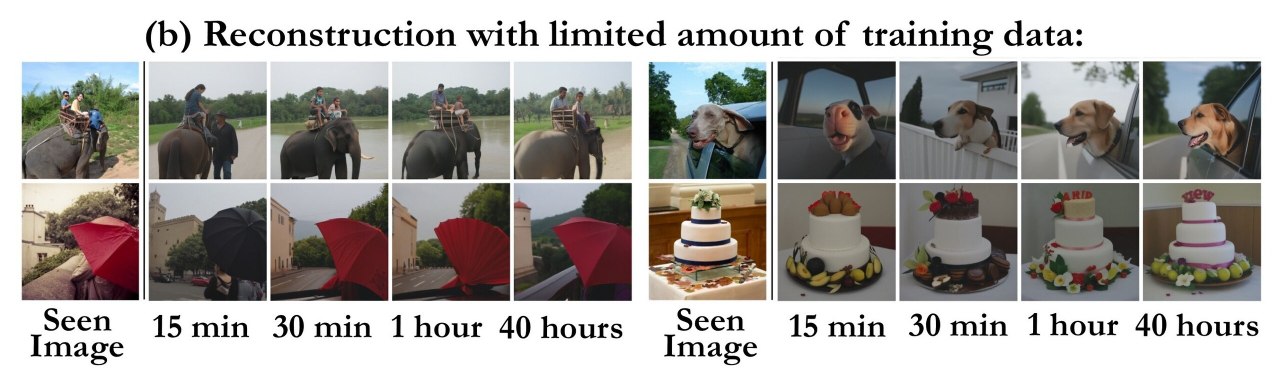
Вторая история — о том, как ИИ достаёт изображение уже из самой головы. В израильском Институте Вейцмана группа профессора Михаль Ирани (ведущий автор работы — Роман Белый) создала модель Brain-IT, которая восстанавливает картинку, увиденную человеком в томографе, по снимкам фМРТ его мозга.
Brain-IT объединяет участки мозга со схожими функциями и предсказывает по ним смысл кадра и его грубую компоновку, а диффузионная модель на основе SDXL дорисовывает изображение. Обучали её на открытом наборе Natural Scenes Dataset: около 73 000 пар «снимок — скан» от восьми добровольцев, каждый из которых провёл в томографе около 40 часов.
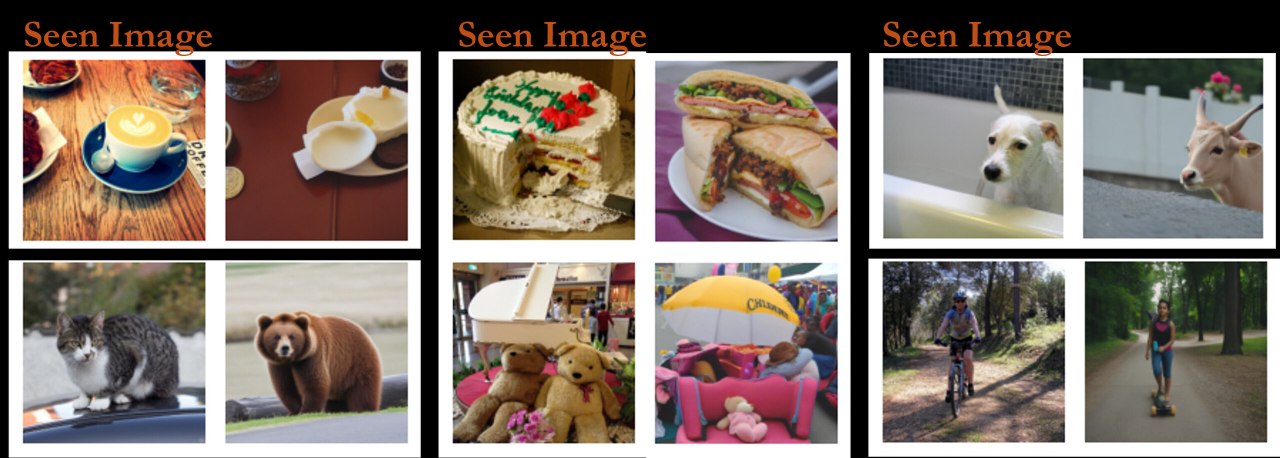
Реконструкции получаются ближе к оригиналу, чем у MindEye2 и других предшественников. А новому человеку хватает всего часа в томографе вместо привычных 40, а узнаваемые картинки выходят даже после 15 минут. Промахи, конечно, тоже есть: торт модель приняла за сэндвич, а собаку в ванной — за козу. Работу представили на конференции ICLR 2026.
Следующая цель — воображаемые образы и даже сны. «Этого у нас пока нет. Но мы к этому стремимся», — говорит Ирани. Вопрос приватности учёные поднимают уже сейчас, хотя пока для такого «чтения мыслей» нужны томограф и долгие часы добровольного участия.
Чтобы сохранить настоящие воспоминания, мы и ценим документальную съёмку: технология Content Credentials хранит в файле историю правок, а энтузиасты собирают даже камеры, которые подписывают каждый кадр.
А вы правили свои семейные фото в ИИ-редакторах, так что, сюжет немного менялся?